Flash-Next + RTX 4080 spill:Spark vs EVO-X3 quality×cost
EVO 上用 RTX 4080 Vulkan layer spill 跑 Flash-Next 三阶段赛。Spark wall_sum 1083s vs EVO+4080 5321s。arch3d EVO 先过;angry EVO 12/12 失败。
一句话。 EVO-X3(AMD 8060S)加 RTX 4080 layer spill 后 Flash-Next 能否跑、Playwright render_ok 相对 Spark 如何变。结果:能跑。wall_sum:Spark 1083s vs EVO+4080 5321s(约 5×)。angry 上 EVO 12/12 失败。
栈:Spark = NVFP4 · SGLang · :30000。EVO = ROCmFP4 GGUF · llama.cpp Vulkan1+Vulkan0 · -ts 56,8 · -c 32768 · :8080。协议同 quality×cost(arch3d → angry → snake,dynamic N)。
Totals
| Spark | EVO + RTX 4080 | |
|---|---|---|
| arch3d → first pass | 357s (r2) | 267s (r1) |
| angry → first pass | 628s (r3) | 12/12 fail (cap) |
| snake → first pass | 98s (r1) | 367s (r2) |
| stages passed | 3/3 | 2/3 |
| wall_sum | 1083s (~18 min) | 5321s (~89 min) |
| decode (pass rounds) | ~37 tok/s | ~21–26 tok/s |
4080 spill 证明能加载、能推理。带质量门时 Spark 便宜得多。EVO 的瓶颈不只是速度,而是 angry HTML 过不了 gate。
Setup · 4080 spill
| DGX Spark | EVO-X3 + 4080 | |
|---|---|---|
| GPU | GB10 UMA ~128GB | 8060S + RTX 4080 (Vulkan1,Vulkan0) |
| weights | Flash-Next NVFP4 | Flash-Next ROCmFP4-FAST ple16 GGUF (~88G) |
| serve | SGLang | -sm layer -ts 56,8 -c 32768 --jinja |
| note | — | -c 4096 时输出在 ~3.8k 截断,closed_html 失败;arch3d 需 32k。 |
Stage 1 · arch3d
EVO r1 即过(267s),比 Spark 首次通过(357s / r2)更短。上下文够长能收尾时,两边 3D HTML 都能过 gate。
37.3 tok/s · 122s · 4559 tok
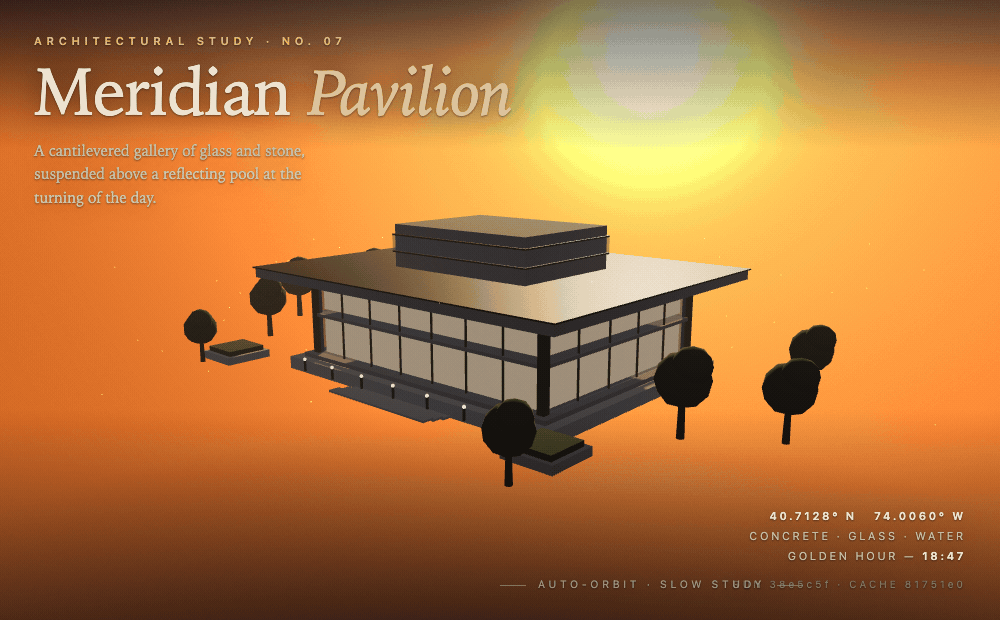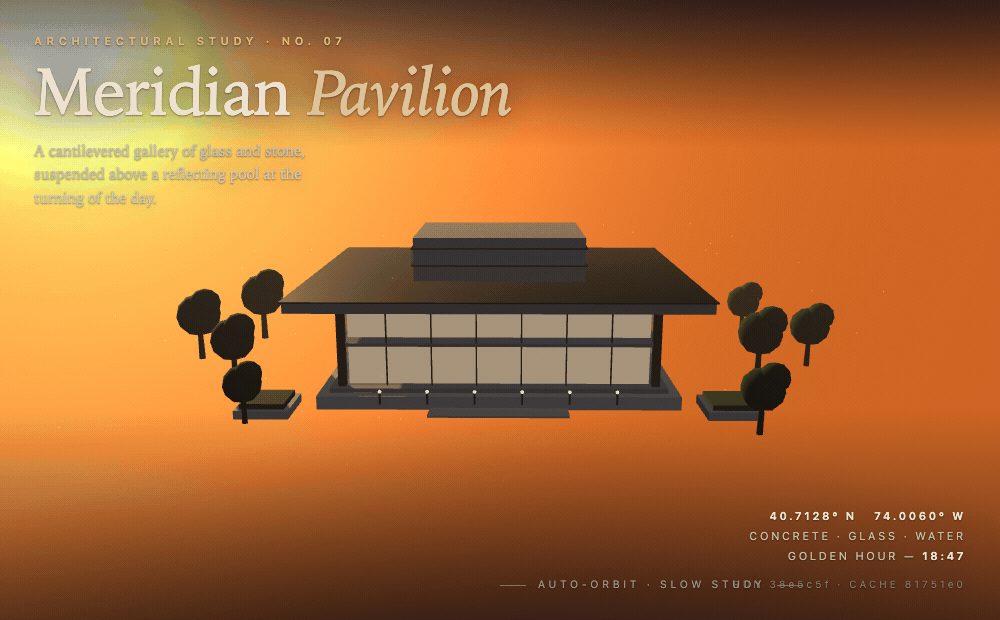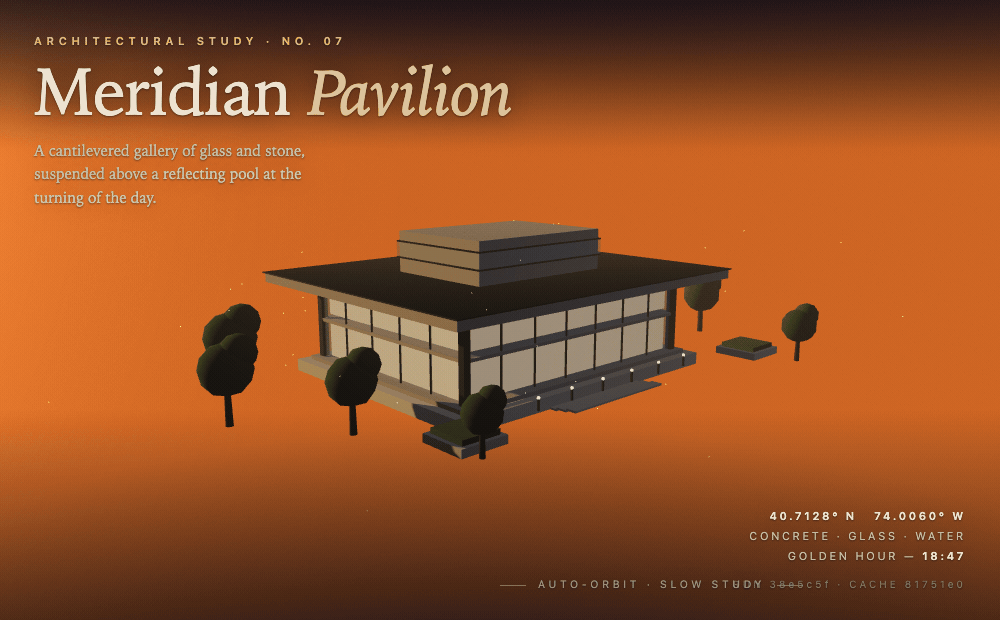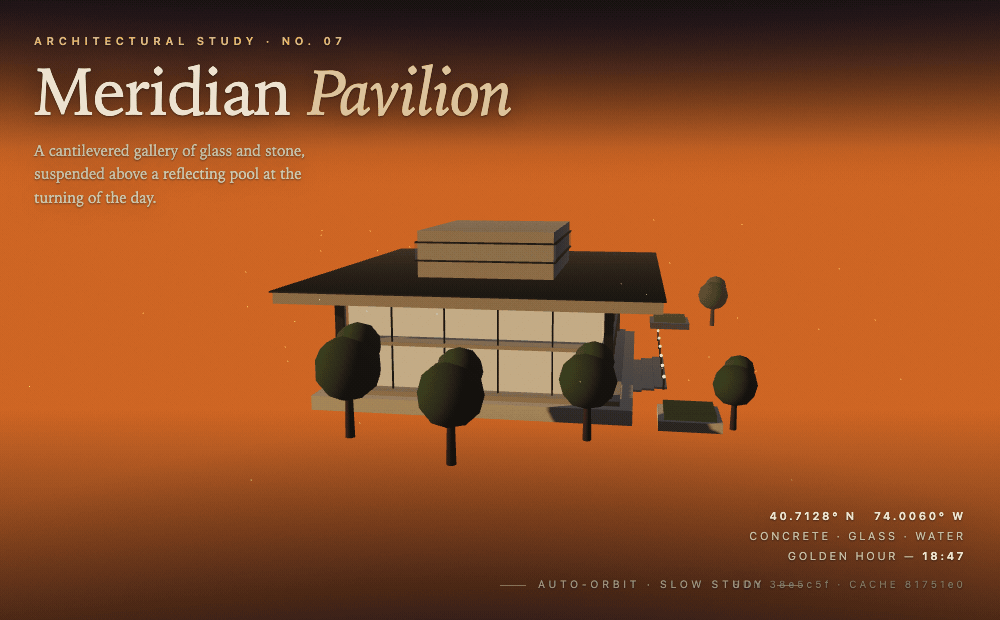
25.6 tok/s · 267s · closed_html OK
Stage 2 · angry
Spark r3 通过(628s)。EVO+4080:12/12 render_ok=false,常缺 requestAnimationFrame / 输入钩子。烧满 8k token 仍出不来可玩弹弓。比先前 AMD-only Flash(angry 最终通过)更差。
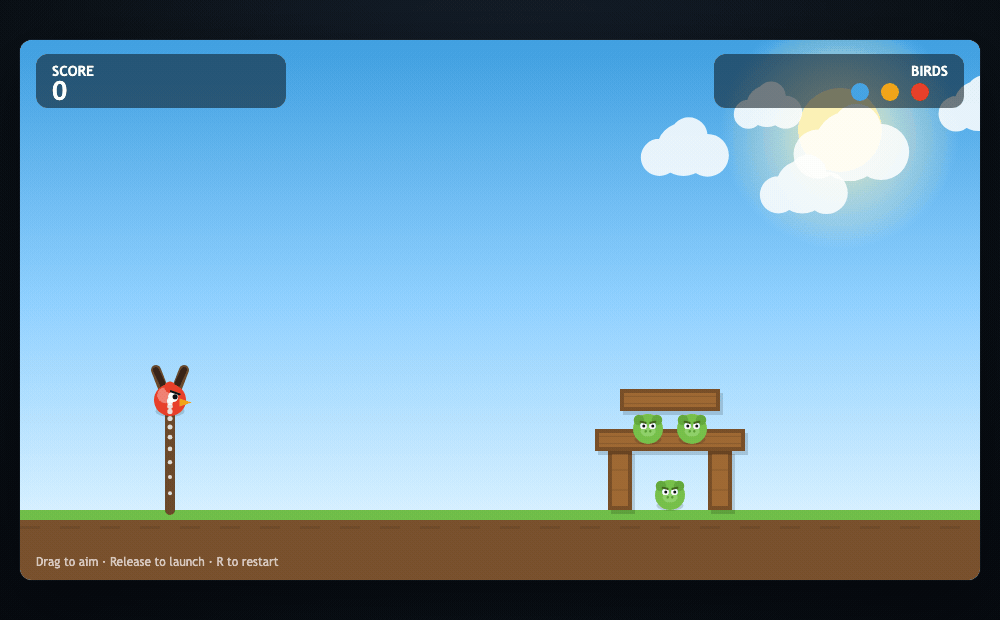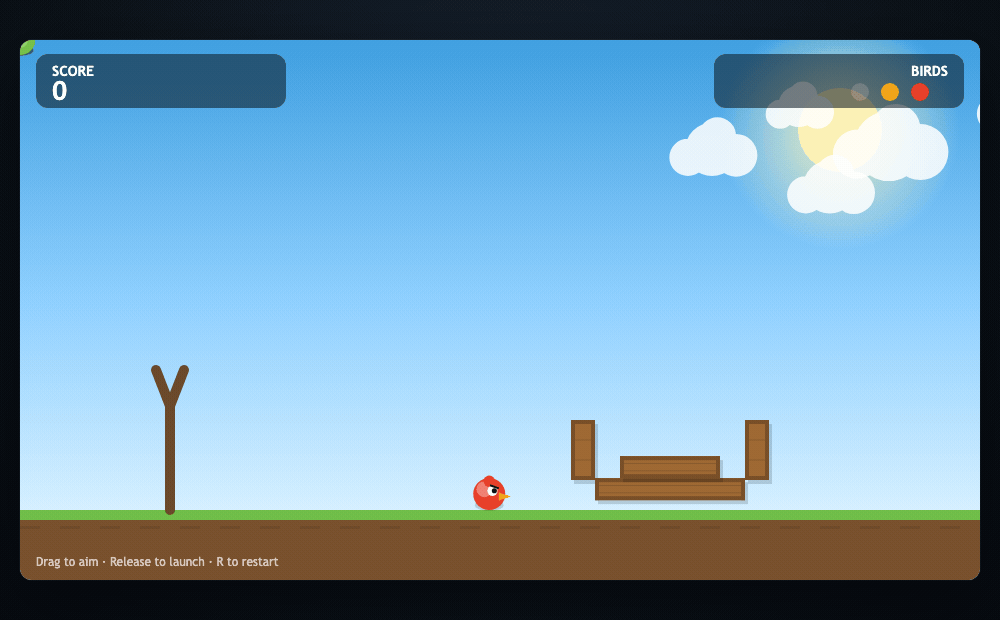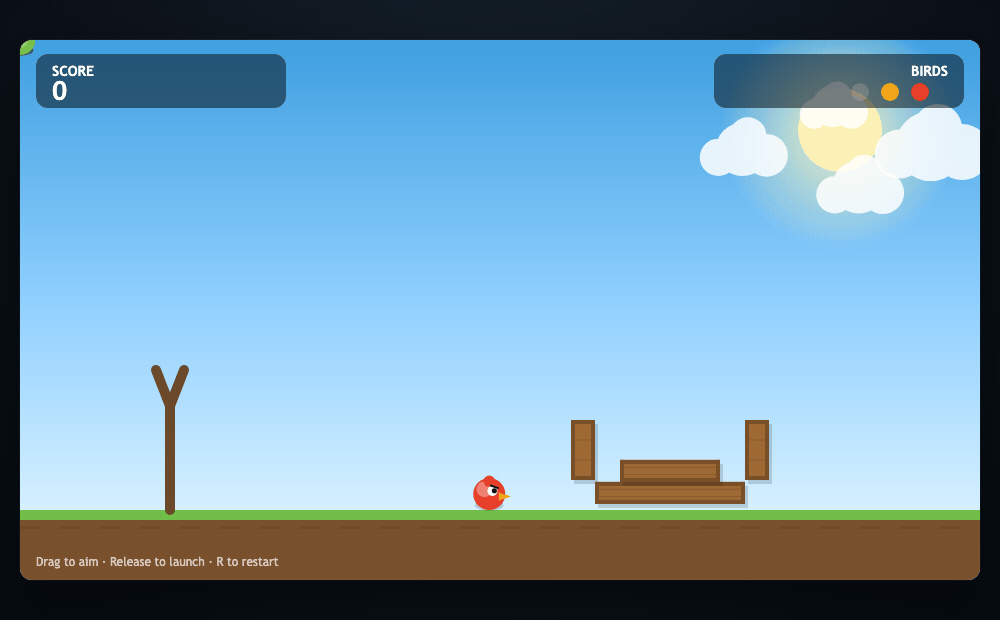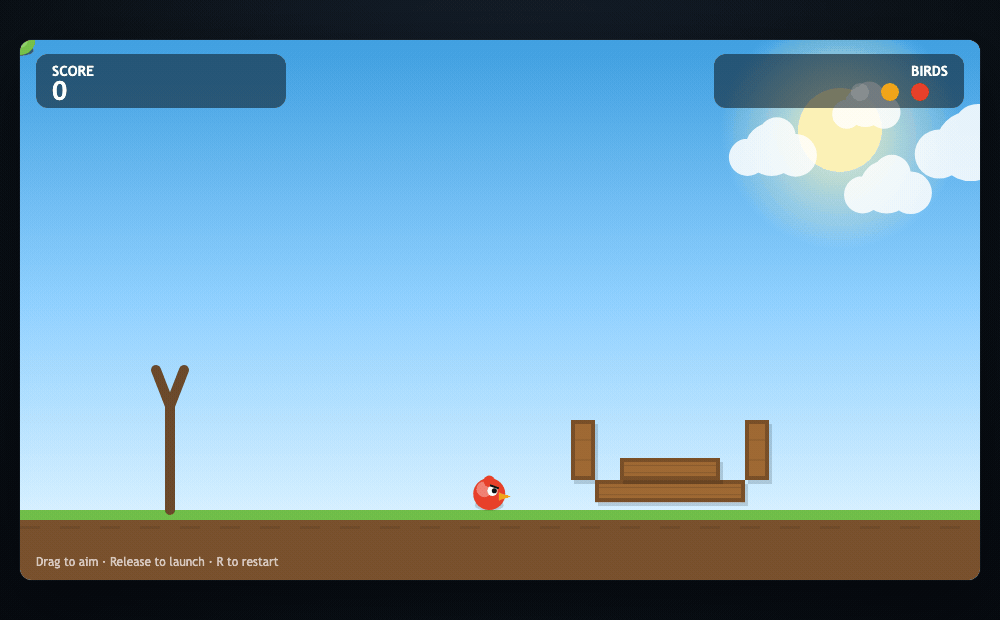
Stage 3 · snake
两边都过。Spark r1(98s · 37 tok/s),EVO r2(367s · 20 tok/s)。
怎么读
- 4080 spill 可行:~88G Flash-Next 可用 AMD+NVIDIA layer split serve;
-c要够大。 - 质量≠速度:EVO decode 约 Spark 的 70%;wall_sum 差距主要来自 angry 重试。
- 先前 AMD-only Flash(wall_sum 3374s)不是干净 A/B——本文只看加 4080 后同一 gate。
源:pipeline-flashnext-spark-vs-4080-v2/pipeline-20260903T151241Z.json · makespan 5403s。